
ACM MM 2026 :全类型音频深度伪造检测

近日,IIP-HCI实验室关于全类型音频深度伪造检测的最新研究成果被多媒体领域顶级国际会议 ACM MM 2026 接收。会议全称为 ACM International Conference on Multimedia,自1993年创办以来…
59 0 0

近日,IIP-HCI实验室关于全类型音频深度伪造检测的最新研究成果被多媒体领域顶级国际会议 ACM MM 2026 接收。会议全称为 ACM International Conference on Multimedia,自1993年创办以来…
来源丨阿里语音AI 近年来,单通道语音分离技术犹如一场精彩的接力赛,从 Conv-TasNet 的精巧卷积,DPRNN 的深度循环,到 SepFormer 和 MossFormer 的 Transformer 革命,再到 TF-GridNe…
来源丨新智元 刚刚,Anthropic和OpenAI同时放出了语音模式大升级! Claude这边,从只能跑Haiku升级到Opus 4.8和Sonnet 5全系列,不仅能在对话里调Gmail、日历、Slack,还扩增到11种语言,但没有中文…


近年来,端到端口语对话(S2S)与语音合成(TTS)技术正加速从“可懂、可用”向“自然、拟人”发展。尤其在智能座舱、语音助手等实际应用场景中,用户对语音交互的期待已不再局限于内容准确,还希望模型能够展现接近真人的表现力,包括细腻的情绪起伏、…

全双工语音对话模型(Spoken Dialogue Model, SDM)已经能够同时进行听、说与被打断的实时交互。但一个更基础的问题始终没有被充分回答: 为全双工 SDM 设计强化学习训练时,应当以何种信号作为奖励? 现有方法大多只覆盖评…
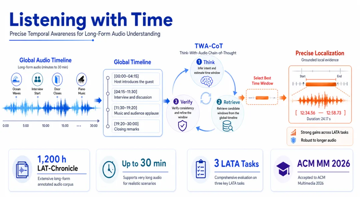
近年来,基于大语言模型(LLM)的音频大语言模型(Large Audio Language Models, LALMs)在音频理解任务上取得了显著进展,在短音频场景中已经展现出优异的性能。然而,当输入扩展到播客、访谈、会议、直播等常见的持续…
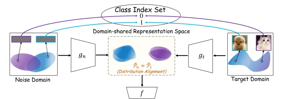
SSNA团队 投稿,量子位 | 公众号 QbitAI 迁移学习里的“源数据”,未必非得是图像、文本或音频。 一组从高斯分布里随机采样出来、没有任何语义的噪声,也能帮助模型在少量标注下学得更好。 这项工作名为半监督噪声自适应(Semi-Sup…
