
声浪

腾讯推出Covo-Audio:7B 参数打通听 - 说 - 思,全双工对话 + 情感共情拉满

论文标题:Covo-Audio Technical Report 论文链接:https://arxiv.org/pdf/2602.09823v1 当语音助手能听懂指令、生成语音时,却常陷入 “逻辑脱节、交互僵硬、音色难定制” 的困境,要么只…
44 0 0
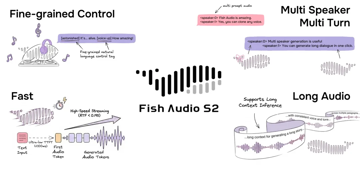
Fish Audio 开源 S2 文本转语音模型,支持1.5万种情感控制,单卡100ms极速推理!
来源丨RET开发者社区 传统的AI语音合成往往因缺乏情感表达而显得机械生硬。Fish Audio最新开源的文本转语音模型Fish Audio S2,致力于解决这一痛点。该模型能够生成包含清嗓、叹息、笑场等细微人类声学特征的语音。 模型权重、…
30 0 0
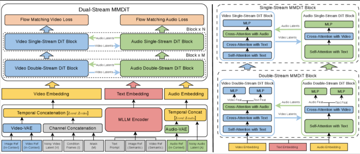
AI生成同步音频的进化,声音制作人真正受到威胁的开始
来源丨AI音频时代 AI似乎已经无处不在,而我们身处的内容产业,AI内容生成技术也像极了即将到来的暴风骤雨,但无论是否还要继续坚持,我们都应该去了解这里面发生了什么。而多年来,视频生成和音频生成一直像两个陌生人,分别待在不同的制造车间里。当…
21 0 0
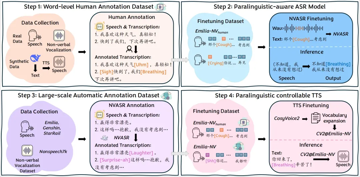
Emilia-NV:让ASR/TTS有“人味儿”的秘诀 | ICASSP2026
我们平时说话,信息不只在“字面内容”里,还藏在各种副语言声音里:笑、喘气、叹气、咳嗽,以及“嗯/啊/哦”这类带态度的语气词。它们在真实对话里承担了大量功能: 表达情绪与态度:开心的笑、无奈的叹气、不耐烦的“哼” 组织对话节奏:思考时的“呃/…
39 0 0
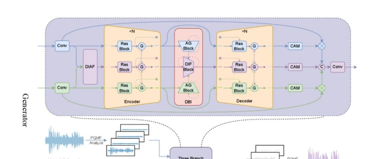
中国科研团队开发DBMIF框架实现骨导与气导语音的智能融合
来源丨21db声学人 在极低信噪比环境下,传统语音增强系统性能急剧下降,气导麦克风常被环境噪音淹没。近日,来自军事科学院国防科技创新研究院、中国科学院声学研究所和计算技术研究所的研究团队提出了一种名为深度平衡多模态迭代融合框架(DBMIF)…
21 0 0
一个模型,搞定所有音频生成任务!多项基准SOTA | ICLR'26
来源丨新智元 港科大团队提出音频生成统一模型AudioX,只需一个模型,就能从文本、视频、图像等任意模态生成高质量音效和音乐,在多项基准上超越专家模型。团队同时开源了700万样本的细粒度标注数据集IF-caps与可控T2A评测基准T2A-b…
23 0 0