GPT-Live——语音智能体的技术路线和架构

以下文章来源于AI语音AI思考 今天 OpenAI 发布了 GPT-Live,展示了令人惊艳的实时语音交互能力。4月份,在豆包发布全双工语音对话模型时,我也曾写过一篇文章,探讨了端到端全双工语音交互背后的技术门槛,以及如何构建一个真正的语音…
36 0 0

以下文章来源于AI语音AI思考 今天 OpenAI 发布了 GPT-Live,展示了令人惊艳的实时语音交互能力。4月份,在豆包发布全双工语音对话模型时,我也曾写过一篇文章,探讨了端到端全双工语音交互背后的技术门槛,以及如何构建一个真正的语音…
近年来,语音合成模型的能力提升很快。只给一小段参考音频,模型就可以模仿目标说话人的音色,读出一段新的文本。但真正把语音克隆系统用起来时会发现,模型不能只"能发声"——它需要同时做到三件事:读对文字、像目标说话人,并且声音自然、清晰、稳定。…
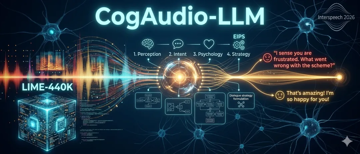
近年来,音频大语言模型(Audio Language Models, ALMs)的出现极大地推动了自然语音对话交互的发展[1][2]。然而,在面对真实场景中强烈的情感陪伴需求时,现有的 ALMs 依然面临深层情感交互的瓶颈。具体而言,模型普…
本期分享杭州电子科技大学智能语音课题组被语音信号处理领域旗舰会议Interspeech 2026录用的4篇论文,涵盖了神经形态语音增强、用户自定义关键词检测、生成式语音增强以及多任务语音理解测评四个主题。 1. Neuromorphic S…
近几年 TTS 发展极快,而我的技术直觉还停留在 FastSpeech 阶段。最近项目重新需要用到 TTS,我便选取了一些近期在资料、仓库和讨论中反复出现,且本地相对容易接入的模型,做了一次面向实际使用的梳理和评测。 需要说明的是,这不是传…
以下文章来自:南京大学音频声学实验室(NJU-AALab) ICASSP(International Conference on Acoustics, Speech, and Signal Processing)是由IEEE信号处理学会主办…