技术漫谈|GPT-Live 之后,我们重新掂量「像人」这件事

两周前 OpenAI 上线GPT-Live,社交媒体上的形容词高度趋同:"像人"、"有温度"、"跟朋友聊天一样"。往前推两个月,Thinking Machines Lab 放出第一批 Interaction Models;同期 xAI 的g…
43 0 0

两周前 OpenAI 上线GPT-Live,社交媒体上的形容词高度趋同:"像人"、"有温度"、"跟朋友聊天一样"。往前推两个月,Thinking Machines Lab 放出第一批 Interaction Models;同期 xAI 的g…
来源:机器之心 刚刚,腾讯混元正式发布新一代语音识别模型 Hy ASR 3.0 preview。基于最新一代大语言模型 Hy3 的语言理解能力,Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感…
以下文章来源:电影声音网 欧盟《人工智能法案》透明度要求已于2026年8月2日生效。 如果你正在使用人工智能对面向欧盟受众的作品进行音频、对话或视频的编辑、修改或生成,那么无论你身处何地,本周末生效的披露规则都将适用。以下是摘要。 01、欧…
零样本语音转换旨在保留语音语言内容的同时,将源说话人音色迁移至任意未见过的目标说话人。随着实时通信、直播互动、在线会议、游戏语音等应用场景的发展,语音转换系统对低延迟、轻量化和高保真流式推理能力提出了更高要求。此前提出的 MeanVC 通过…
通义千问团队今日正式发布 Qwen 3.8-Max,参数规模达 2.4 万亿(活跃参数 95B),成为 Qwen 家族迄今最强的模型,模型权重将于下周开源。这是 Qwen 首次对 Max 级别模型开放权重。 千问AI平台:https://w…
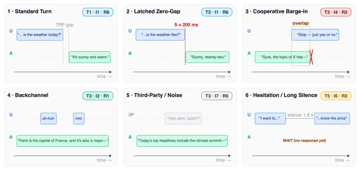
以下文章来源于乐百一家 论文题目:A Survey of Full-Duplex Spoken Dialogue Systems: Architectural Hierarchy, Interaction Ontology, and Dec…
今天,阿里千问发布Qwen-Audio-3.0-Gen-Preview。它把各类音频元素的生成与编排统一到同一个模型里,只需一段场景描述,就能在同一条时间轴上同时生成多角色对白、环境声、动作音效和背景音,输出可直接使用的成品音轨。 技术报告…
来源丨字节跳动Seed 今天,字节发布新一代视频创作模型Seedance 2.5。 Seedance 2.0 发布后,团队观察到,用户对视频创作模型的期待正在从"生成一个片段"走向"完成一段创作"。Seedance 2.5 延续了 Seed…
