声浪

ASRU2025丨上交大听觉认知与计算声学实验室6篇录用论文分享

作为语音相关研究领域的旗舰国际会议,ASRU2025(IEEE Workshop on Automatic Speech Recognition and Understanding)将于12月6-10日在夏威夷檀香山举办。IEEE ASRU…
23 0 0
快手可灵 2.6上线,一次生成、音画同出
快手旗下可灵AI正式推出其2.6版本的“音画同出”模型,这是首个支持画面、自然人声、音效及环境氛围同步生成的多模态系统。仅需一次生成,即可输出完整的音视频内容,真正实现了声音与画面的深度融合。 在创作流程上,可灵2.6提供两条高效创作路径:…
18 0 0
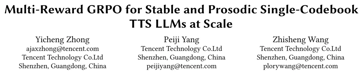
腾讯团队提出多奖励GRPO框架优化TTS韵律与稳定性,显著提升 TTS 自然度
标题:Multi-Reward GRPO for Stable and Prosodic Single-Codebook TTS LLMs at Scale 链接:https://arxiv.org/pdf/2511.21270 作者单位:…
23 0 0
AAAI 2026|KALL-E:基于下一分布预测的自回归语音合成
文本到语音(TTS)合成技术正处在一个由大语言模型(LLM)驱动的范式变革时代。目前,学界主流的“下一令牌预测”范式统一了语音生成的框架,但其依赖的“离散化”基石也带来了信息瓶颈、生成幻觉等固有缺陷。虽然已有研究开始转向连续语音表示,但又面…
23 0 0