快手可灵 2.6上线,一次生成、音画同出

快手旗下可灵AI正式推出其2.6版本的“音画同出”模型,这是首个支持画面、自然人声、音效及环境氛围同步生成的多模态系统。仅需一次生成,即可输出完整的音视频内容,真正实现了声音与画面的深度融合。 在创作流程上,可灵2.6提供两条高效创作路径:…
20 0 0

快手旗下可灵AI正式推出其2.6版本的“音画同出”模型,这是首个支持画面、自然人声、音效及环境氛围同步生成的多模态系统。仅需一次生成,即可输出完整的音视频内容,真正实现了声音与画面的深度融合。 在创作流程上,可灵2.6提供两条高效创作路径:…
标题:Multi-Reward GRPO for Stable and Prosodic Single-Codebook TTS LLMs at Scale 链接:https://arxiv.org/pdf/2511.21270 作者单位:…
最近阿里在开源界频出狠活,不仅放出了 6B 大小的 Z-Image-Turbo,还开源了一款 7B 参数的主打「图中文字」的文生图模型:Ovis-Image。 图中的“文字渲染”能力是它的强项,也就是生成海报、宣传图、Logo、UI 原型、…
文本到语音(TTS)合成技术正处在一个由大语言模型(LLM)驱动的范式变革时代。目前,学界主流的“下一令牌预测”范式统一了语音生成的框架,但其依赖的“离散化”基石也带来了信息瓶颈、生成幻觉等固有缺陷。虽然已有研究开始转向连续语音表示,但又面…
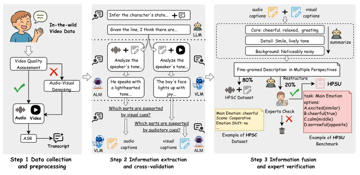
标题:《HPSU: A Benchmark for Human-Level Perception in Real-World Spoken Speech Understanding》 链接:https://arxiv.org/pdf/251…
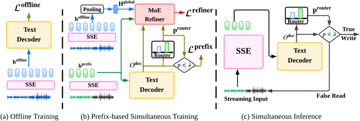
NeurIPS(Neural Information Processing Systems)是每年十二月举行的机器学习与计算神经科学国际会议。会议汇集了来自学术界和工业界的顶尖研究人员,领域涵盖机器学习、神经网络、认知科学、计算机视觉,统计…
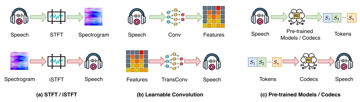
题目:《Advances in Speech Separation: Techniques, Challenges, and Future Trends》 地址:https://arxiv.org/pdf/2508.10830 先从摘要说起…
