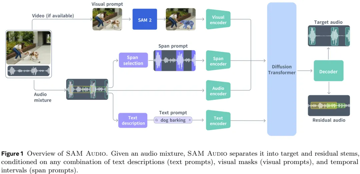
分割一切、3D重建一切还不够,Meta开源SAM Audio分割一切声音

继 SAM(Segment Anything Model)、SAM 3D后,Meta 又有了新动作。 深夜,Meta 放出音频分割模型SAM Audio,其通过多模态提示(无论是文本、视觉,还是标注时间片段),让人们能够轻松地从复杂的音频混…
23 0 0

继 SAM(Segment Anything Model)、SAM 3D后,Meta 又有了新动作。 深夜,Meta 放出音频分割模型SAM Audio,其通过多模态提示(无论是文本、视觉,还是标注时间片段),让人们能够轻松地从复杂的音频混…
标题:Joint Speech and Text Training for LLM-Based End-to-End Spoken Dialogue State Tracking 地址:https://arxiv.org/pdf/2511.…
只需3秒录音,就能让你的声音无缝切换语种、方言与情绪——中、粤、日、英、开心、愤怒......9 种通用语言、18种方言,通通搞定! 一段嘈杂环境下的会议录音,AI 也能毫秒级输出文字,绕口令、RAP、背景音乐干扰,照样精准识别! 通义百聆…
A Survey on Speech Large Language Models for Understanding 论文作者:彭景¹²*,王雨诚³*,李波含¹²,郭奕玮¹²,王翰坤¹²,方衍贵⁵,奚彧¹²,李浩宇¹²,李旭⁴,张克⁶,王帅…
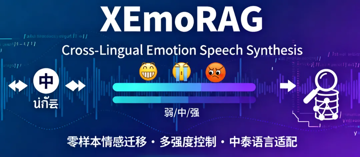
跨语言情感语音合成(Cross-lingual Emotional Speech Synthesis)旨在在不改变语音语言内容信息的前提下,将源语言语音中的情感特征自然迁移到目标语言的合成语音中。这一技术在电影配音、多语言虚拟人等场景中有着…
本系列的十篇文章,是对之前文章中提到的十个趋势进行详细的剖析。 关于未来语音技术和应用趋势的10点看法 在这个系列文章中,会穿插科普、技术综述、技术发展路线,以及一些个人和其他行业专家的思考。希望通过这一系列文章,无论读者之前对语音技术和应…
大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
