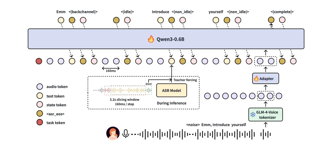
语音对话里的轮次判断:从级联到统一

本文来源:听见未来Tech 全双工(full-duplex)语音交互要求系统在用户说话的同时并行完成识别、理解与响应决策,其核心难点在于判断当前话轮是否结束——决定何时接话、何时继续等待。传统 VAD(Voice Activity Dete…
44 0 0

本文来源:听见未来Tech 全双工(full-duplex)语音交互要求系统在用户说话的同时并行完成识别、理解与响应决策,其核心难点在于判断当前话轮是否结束——决定何时接话、何时继续等待。传统 VAD(Voice Activity Dete…
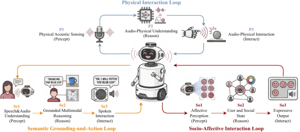
本文来源:SV4GoodAIlab 论文题目:Audio Embodied Intelligence: Auditory Perception, Reasoning, and Interaction for Multimodal Agent…
本期将介绍上海交通大学听觉认知与计算声学实验与 Microsoft Research Asia 合作完成的论文 TF-MoE: Time-Frequency Mixture-of-Experts for Efficient Speech S…
从赛事启动、数据发布,到公开评测、隐藏评测与系统复核,ChinaVoices Challenge 2026 中文多方言语音识别挑战赛现已圆满完成各项赛程。经过组委会对参赛结果、系统材料与合规情况的综合核验,赛事最终结果于近日正式发布! 本届…
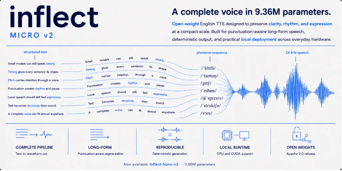
以下文章来源:努力犯错玩AI 近日,独立开发者 Owen Song 发布了 Inflect v2。这是一个极致轻量的英文语音合成模型。Micro 版只有 9.36M 参数,FP32 权重只有 37.5MB。Nano 版更是只有 3.97M…
良好的音频生成范式大概的确需要 latent。待压缩的音频无论取 patch 还是 STFT,从无到有的新 dim,本质上都承担着时域压缩的功能;但音频在不同时间尺度下有无法归纳的 semantic 周期,在频域做 polar 或原始 co…
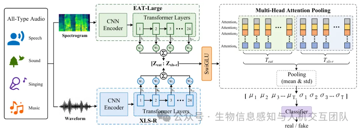
近日,IIP-HCI实验室关于全类型音频深度伪造检测的最新研究成果被多媒体领域顶级国际会议 ACM MM 2026 接收。会议全称为 ACM International Conference on Multimedia,自1993年创办以来…
